siRNA数据分析步骤
Small RNA,指长度小于200bp的RNA序列,通常不能翻译为蛋白,但在基因表达的调控中起作用。
一般而言,小RNA可以分为miRNA, piRNA, siRNA, snRNA, snoRNA, rRNA, tRNA等。
sRNA-seq没有固定的pipeline,根据具体需求有不同的分析步骤。本文整理了siRNA的处理流程。
所需软件:fastqc fastp blast+ bowtie mirdeep2
以我的数据为例:
工作目录/pub4/zhangchao/Methylome_Soybean/sRNA-seq
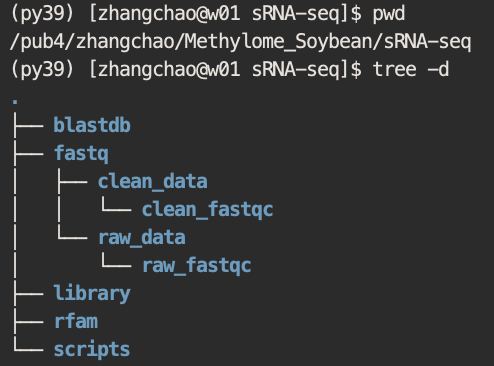
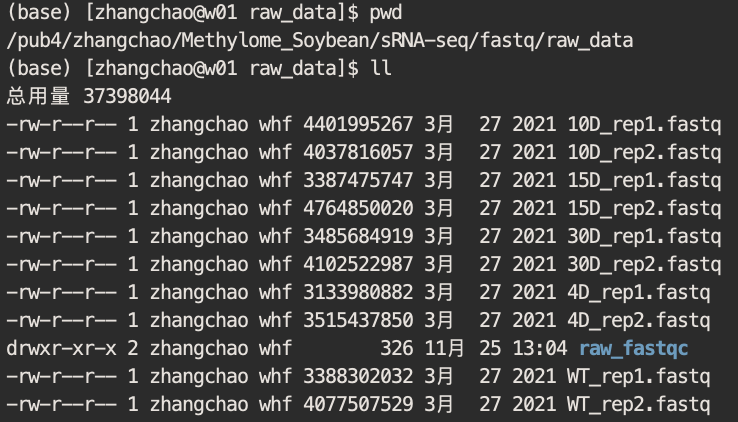
原始数据存放在fastq/raw_data中:
5个样本,每个样本两个重复,单端测序
脚本文件位于scripts目录
1、原始数据质控
Section titled “1、原始数据质控”使用fastqc对原始数据质控,代码如下:
raw_fastqc.sh
#!/bin/sh# rawdata fastqcif [ -d ~/Methylome_Soybean/sRNA-seq/fastq/rwa_data/fastqc]then echo "fastqc directory has existed."else mkdir ~/Methylome_Soybean/sRNA-seq/fastq/rwa_data/fastqc echo "fastqc directory is newly created."ficd ~/Methylome_Soybean/sRNA-seq/fastq/raw_datals *fastq | cut -d . -f 1 |while read id;do fastqc -i ${id}.fastq -o ./fastqcdone部分结果如下:
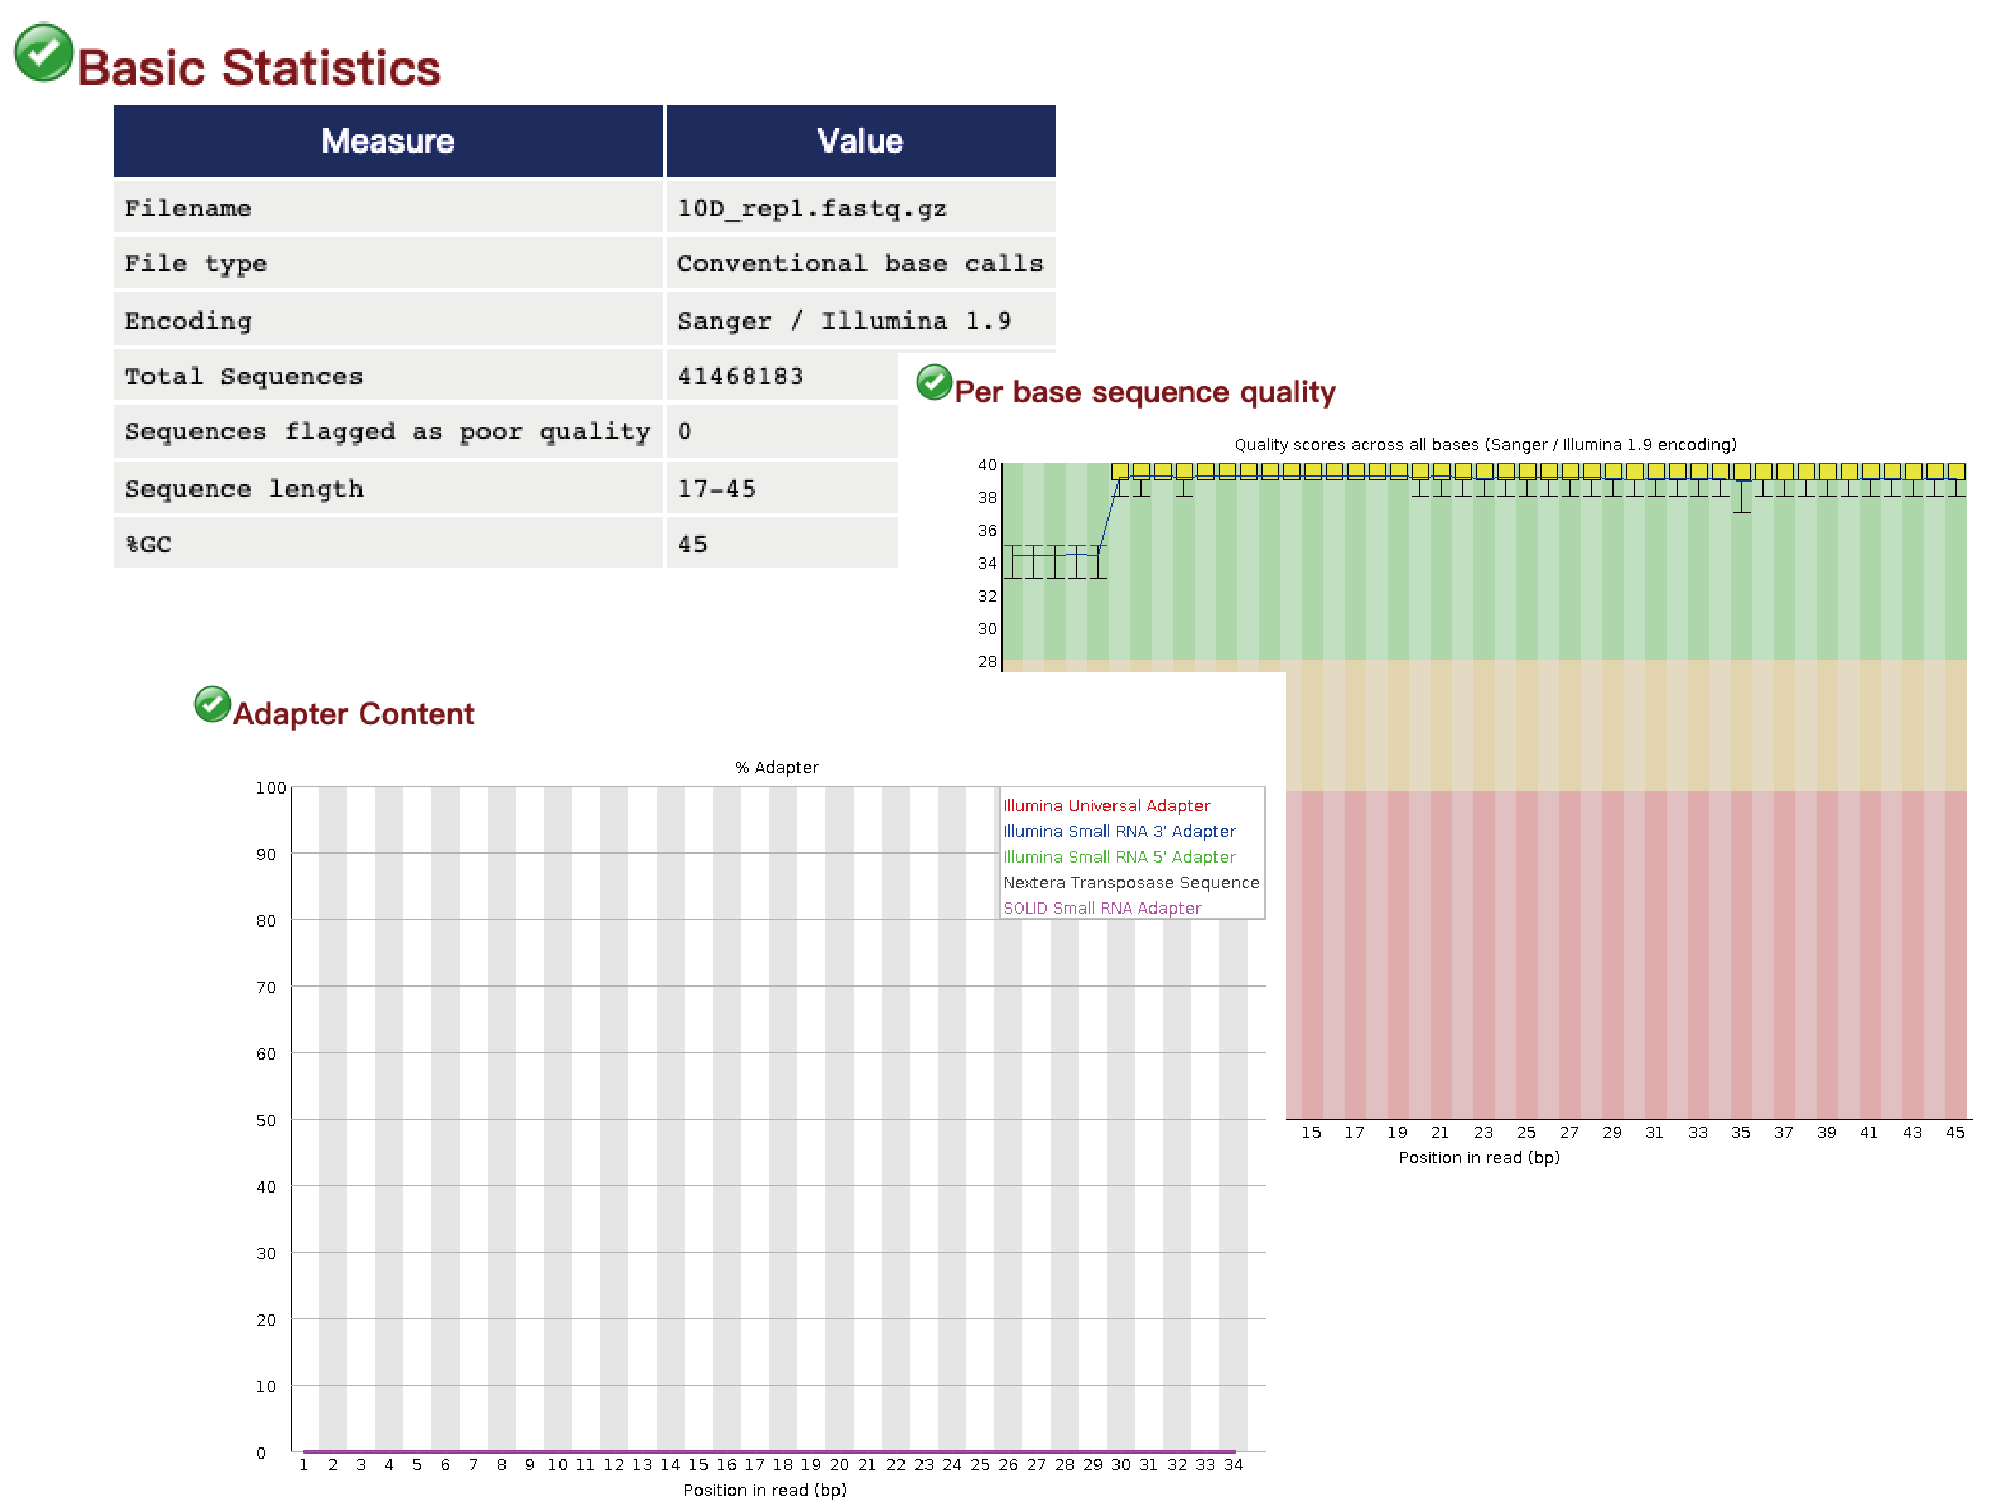
可见拿到的数据质量已经很高了,并且adapter也已经去除。
接下来主要对reads长度进行筛选
2、质量过滤
Section titled “2、质量过滤”使用fastp进行筛选,代码如下:
fastp.sh
#!/bin/bash# fastpif [ -d ~/Methylome_Soybean/sRNA-seq/fastq/clean_data ]then    echo "clean_data directory has existed."else    mkdir ~/Methylome_Soybean/sRNA-seq/fastq/clean_data    echo "clean_data directory is newly created."ficd ~/Methylome_Soybean/sRNA-seq/fastq/raw_datals *fastq | cut -d . -f 1 |while read id;do    fastp -i ${id}.fastq \    -o ../clean_data/${id}_clean.fastq \    -q 20 -u 20 \   #reads中,超过20%的碱基质量低于20则切除    -5 -3 \         #两端滑窗,默认4bp,质量低于20则切除    -A \            #这个参数意思是跳过去接头的步骤,不加则自动去接头,-a 可以指定接头    --length_required 18 \  #过滤掉小于18bp的reads    --length_limit 30       #过滤掉大于30bp的readsdone
#对过滤后的clean reads进行二次质控if [ -d ~/Methylome_Soybean/sRNA-seq/fastq/clean_data/clean_fastqc]then    echo "clean_fastqc directory has existed."else    mkdir ~/Methylome_Soybean/sRNA-seq/fastq/clean_data/clean_fastqc    echo "clean_fastqc directory is newly created."cd ~/Methylome_Soybean/sRNA-seq/fastq/clean_datals *clean_fastq | cut -d . -f 1 |while read id;do    fastqc -i ${id}.fastq -o ./clean_fastqcdone
3、过滤掉已知的其它小RNA
Section titled “3、过滤掉已知的其它小RNA”小RNA测序得到的reads中也包含了许多其它小RNA,如rRNA, tRNA, snRNA, miRNA等,需要将这些序列去除。
我们从Rfam和RNAcentral下载已注释的小RNA序列,用blast方法将它们筛除,剩余的序列进行下一步分析。
3.1 小RNA库下载
Section titled “3.1 小RNA库下载”3.1.1 Rfam库
Section titled “3.1.1 Rfam库”进入Rfam
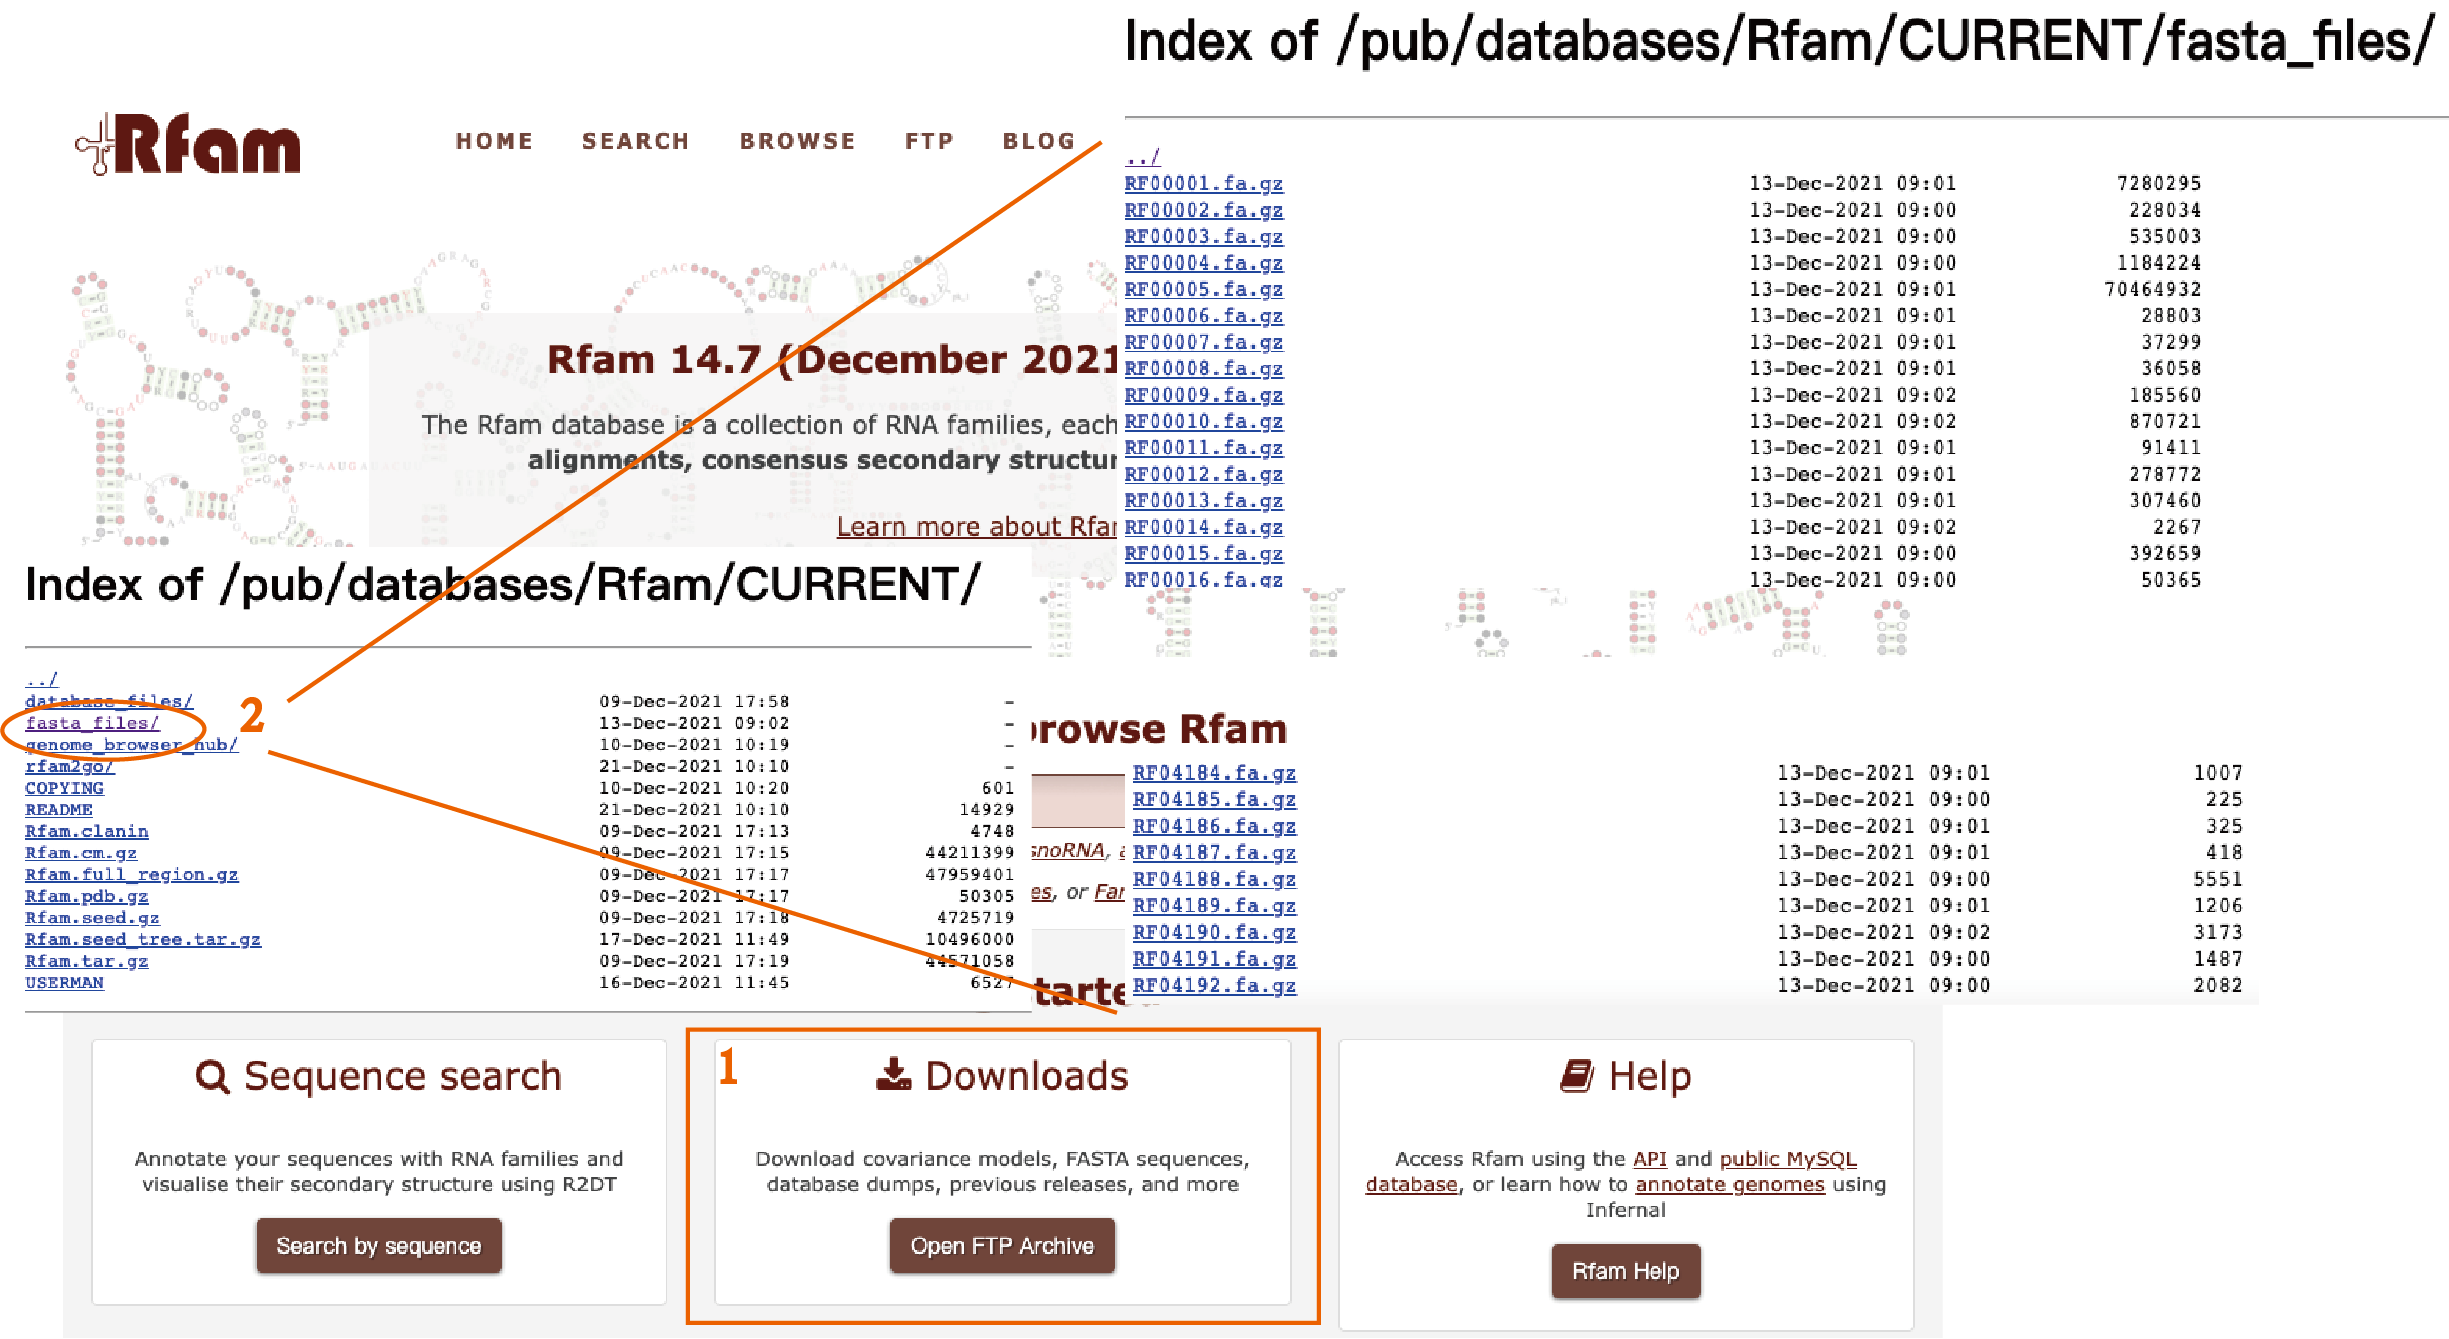
其中共有4192个fasta文件
创建 ~/Methylation_soyeban/sRNA_seq/rfam目录,下载Rfam库的所有fasta文件并解压
mkdir ~/Methylation_soyeban/sRNA_seq/rfamcd ~/Methylation_soyeban/sRNA_seq/rfamcurl -O ftp://ftp.ebi.ac.uk/pub/databases/Rfam/CURRENT/fasta_files/RF0[0001-4192].fa.gzgunzip *gz接下来,复制Rfam库的taxonomy信息,获得库中rRNA,tRNA,snRAN,miRNA等对应的RF文件编号
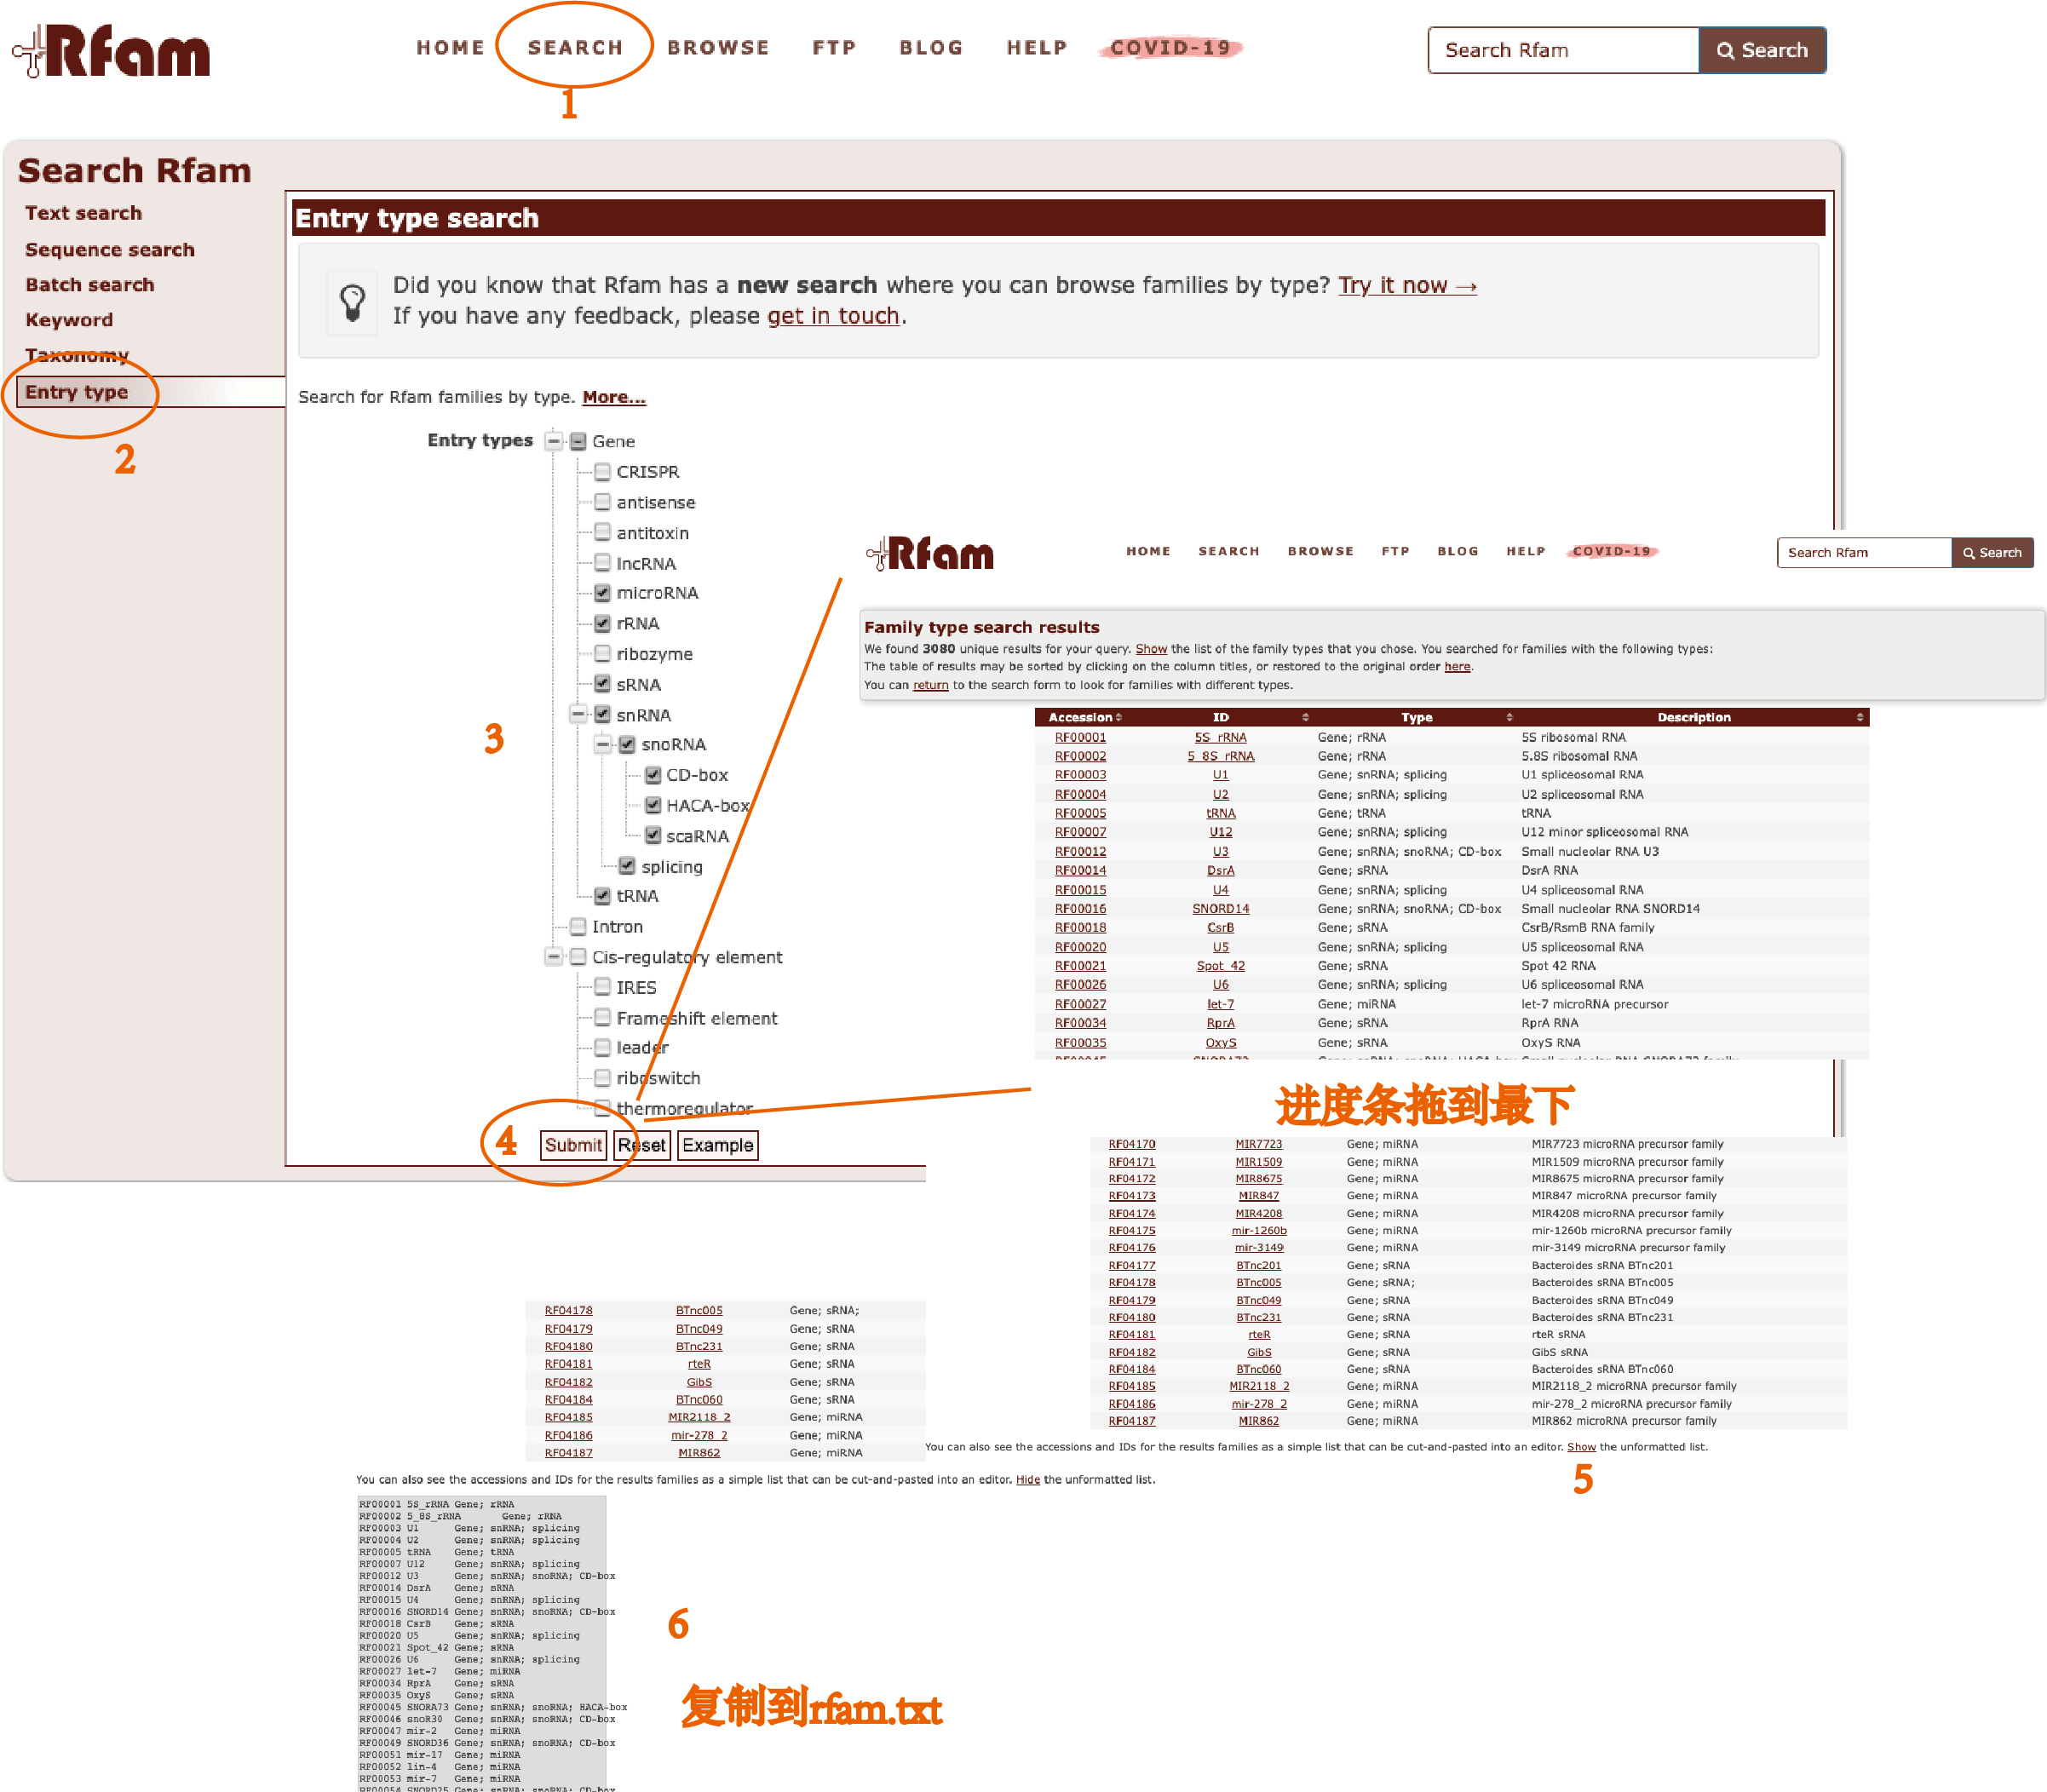
将rfam.txt文件放到目录~/Methylation_soyeban/sRNA_seq/library中,根据小RNA分成多个txt文件
cd ~/Methylation_soyeban/sRNA_seq/librarygrep 'rRNA' rfam.txt >rfam.rrna.txtgrep 'tRNA' rfam.txt >rfam.trna.txtgrep 'sRNA' rfam.txt >rfam.srna.txtgrep 'snRNA' rfam.txt >rfam.snrna.txtgrep 'miRNA' rfam.txt >rfam.mirna.txt根据分类的文件信息,从Rfam库中筛选出大豆各类小RNA的fasta文件
cd ~/Methylation_soyeban/sRNA_seq/rfamrrna_no=`awk '{print $1}' ../library/rfam.rrna.txt|sed 's/$/&\.fa/g'`cat $rrna_no|sed -n '/Glycine max/{p;n;p}' > ../library/rfam.gm.rrna.fa
trna_no=`awk '{print $1}' ../library/rfam.trna.txt|sed 's/$/&\.fa/g'`cat $trna_no|sed -n '/Glycine max/{p;n;p}' > ../library/rfam.gm.trna.fa
srna_no=`awk '{print $1}' ../library/rfam.srna.txt|sed 's/$/&\.fa/g'`cat $srna_no|sed -n '/Glycine max/{p;n;p}' > ../library/rfam.gm.srna.fa
snrna_no=`awk '{print $1}' ../library/rfam.snrna.txt|sed 's/$/&\.fa/g'`cat $snrna_no|sed -n '/Glycine max/{p;n;p}' > ../library/rfam.gm.snrna.fa
mirna_no=`awk '{print $1}' ../library/rfam.mirna.txt|sed 's/$/&\.fa/g'`cat $mirna_no|sed -n '/Glycine max/{p;n;p}' > ../library/rfam.gm.mirna.fa
3.1.2 RNAcentral库
Section titled “3.1.2 RNAcentral库”进入RNAcentral
在搜索框输入物种,在左侧边栏依次点选不同类型的小RNA并下载fasta文件到library目录
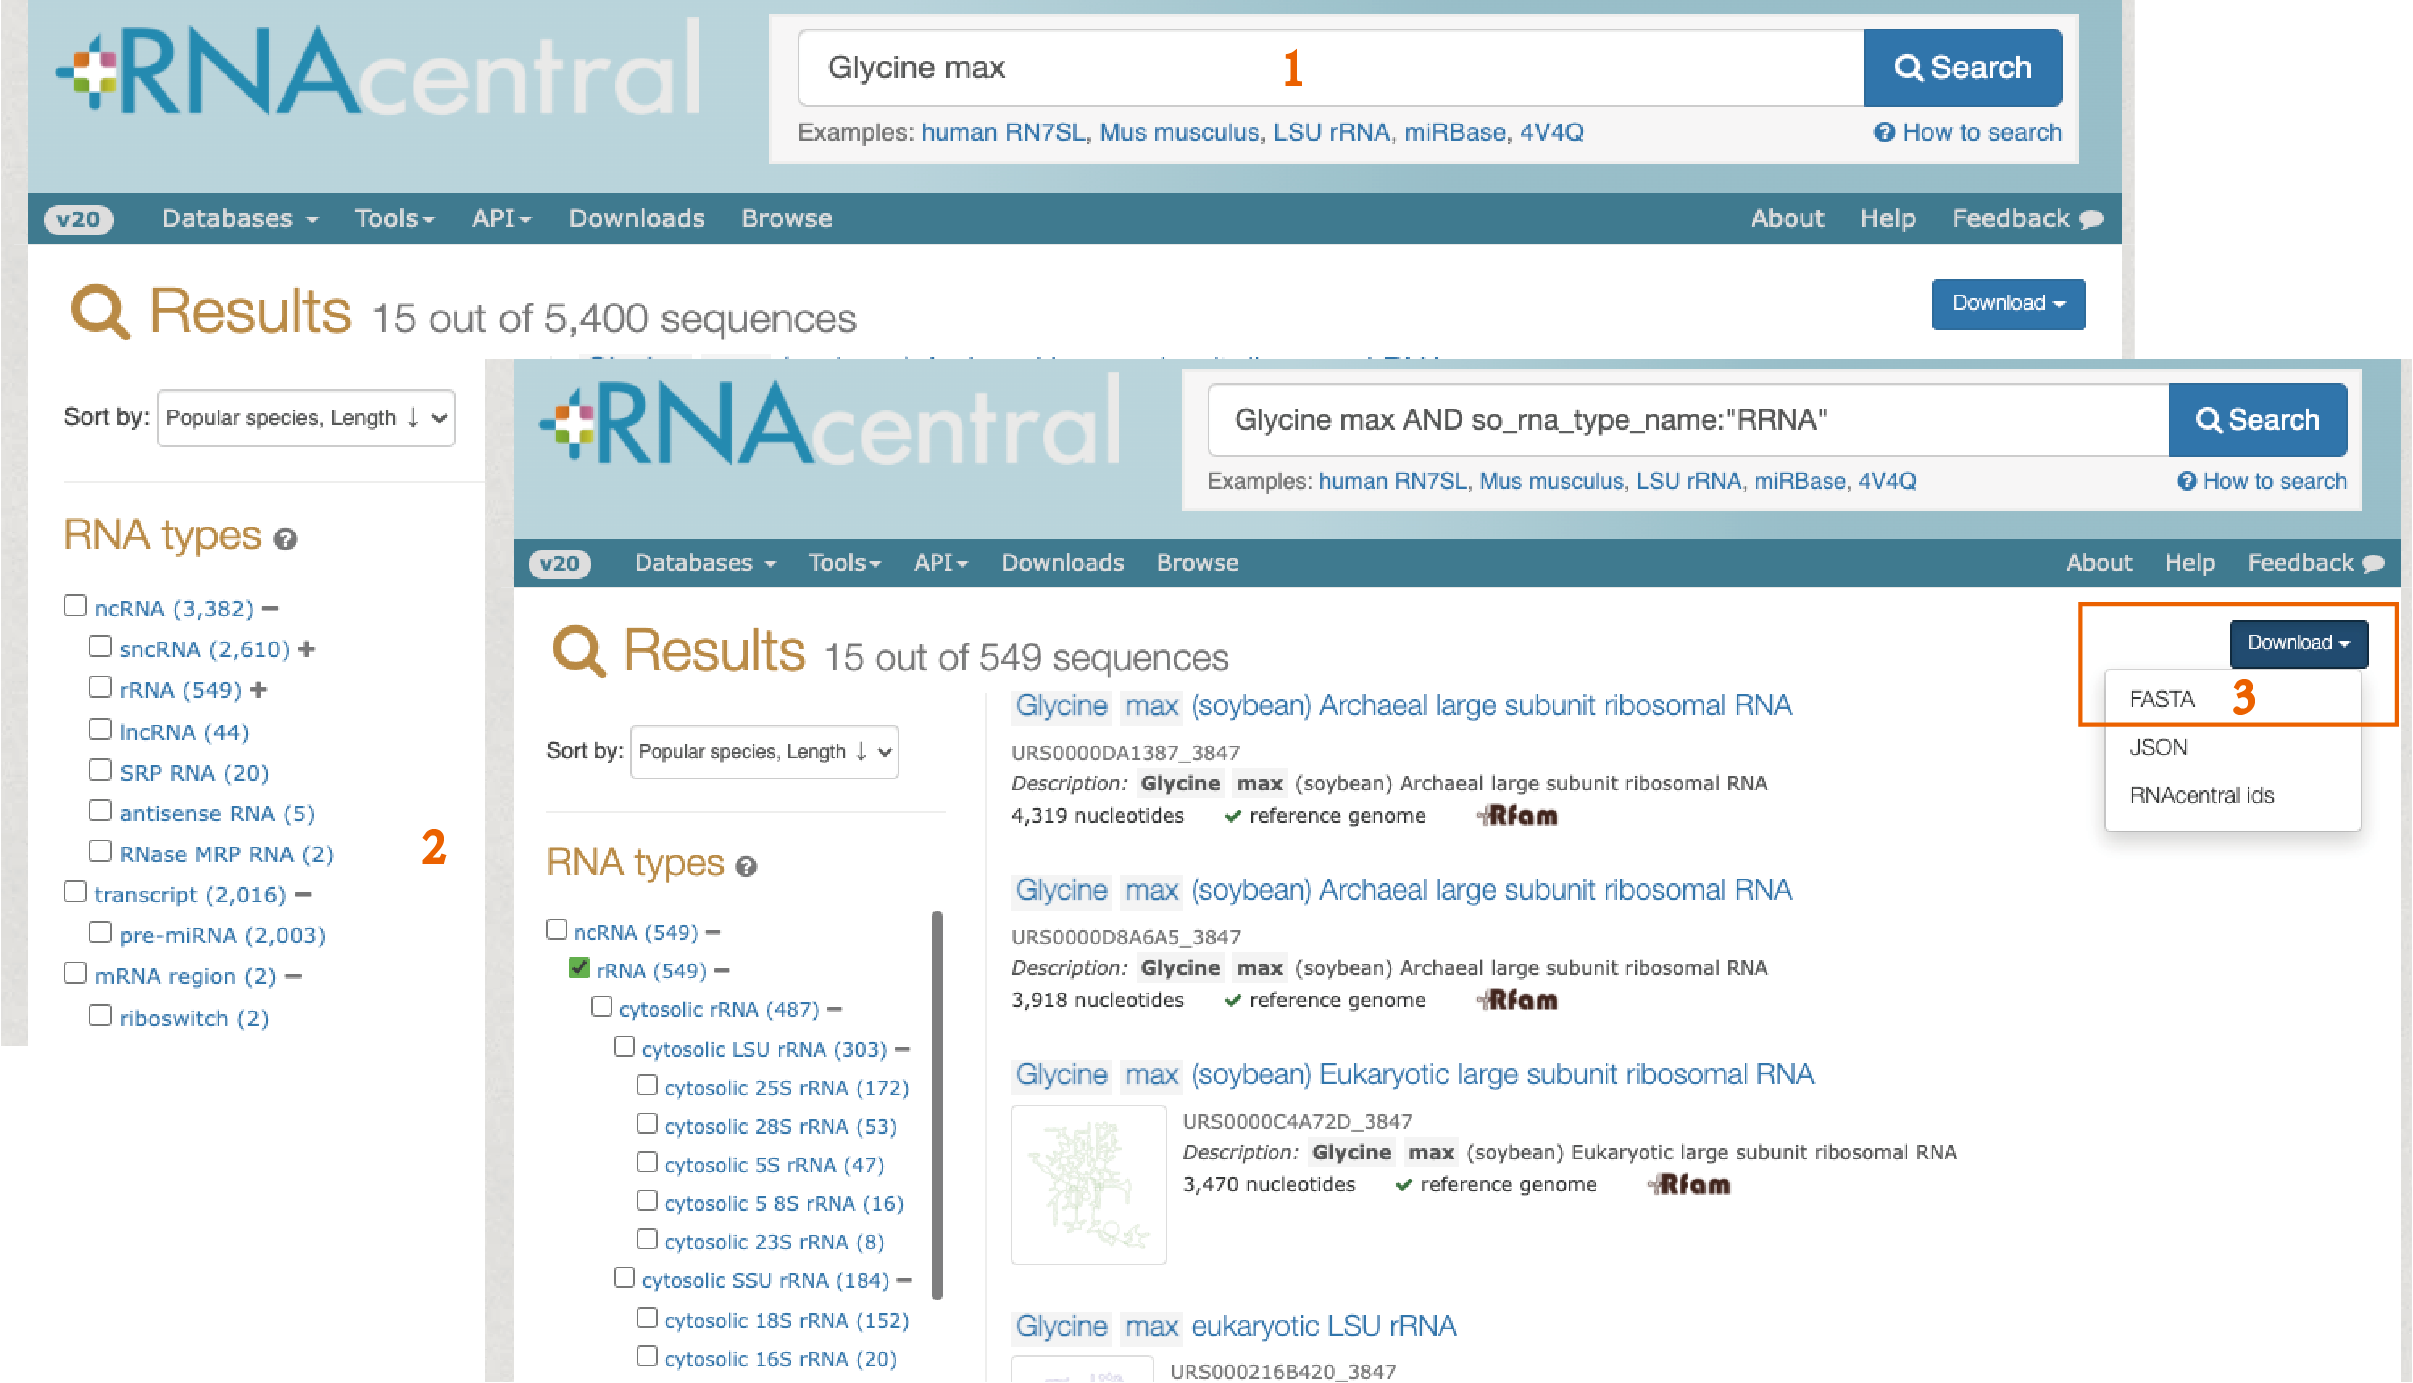
本次需要rrna, trna, snrna snorna, mirna, premirna
3.1.3 合并fasta文件并建库
Section titled “3.1.3 合并fasta文件并建库”cd ~/Methylation_soyeban/sRNA_seq/librarycat rfam.rrna.fa central.rrna.fa > gm.rrna.facat rfam.trna.fa central.trna.fa > gm.trna.facat rfam.srna.fa rfam.snrna.fa central.snrna.fa central.snorna.fa > gm.snrna.facat rfam.mirna.fa central.mirna.fa central.premirna.fa > gm.snrna.facd ~/Methylation_soyeban/sRNA_seq/blastdbmakeblastdb -in ../library/gm.rrna.fa -dbtype nucl -title gm.rrna -out gm.rrnamakeblastdb -in ../library/gm.trna.fa -dbtype nucl -title gm.trna -out gm.trnamakeblastdb -in ../library/gm.snrna.fa -dbtype nucl -title gm.snrna -out gm.snrnamakeblastdb -in ../library/gm.mirna.fa -dbtype nucl -title gm.mirna -out gm.mirna3.2 reads简并
Section titled “3.2 reads简并”测序结果中含有许多相同的小RNA序列,使用mirdeep2将相同的reads简并到一条,可以提高blast效率
mirdeep2的collapse_reads_md.pl可以根据输入的fasta文件和给定的3字符代号将重复reads计数,为了方便将文件名作修改为s11.fastq, s12.fastq, s21.fastq…
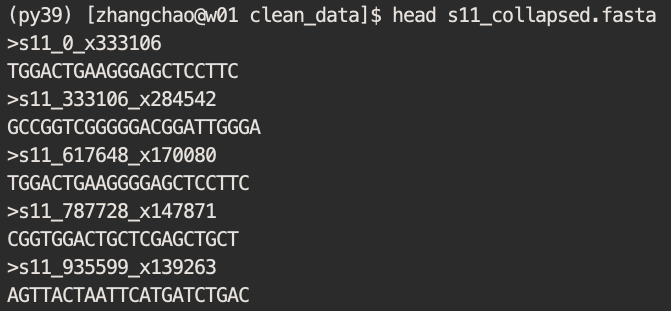
#!/bin/bashcd ~/Methylome_Soybean/sRNA-seq/fastq/clean_datals *.fastq | cut -d . -f 1|while read id;do echo ${id} awk '{if(NR%4 == 2){print">"$0"\n"$0}}' ${id}.fastq > ${id}.fasta collapse_reads_md.pl ${id}.fasta ${id} > ${id}_collapsed.fastadone得到结果如下图所示,表示这条序列有333106次重复
3.3 blastn比对,获得fasta文件
Section titled “3.3 blastn比对,获得fasta文件”用blast-short进行序列比对,挑选出没有比对到小RNA库的序列作为putative siRNAs
#!/bin/bashif [ -d ~/Methylome_Soybean/sRNA-seq/blastresult ]thenecho "the directory for blast_result has existed."elsemkdir ~/Methylome_Soybean/sRNA-seq/blastresultecho "the directory for blast_result is newly created."ficd ~/Methylome_Soybean/sRNA-seq/fastq/clean_datals *collapsed.fasta |cut -d _ -f 1|while read id;do    mkdir ~/Methylome_Soybean/sRNA-seq/blastresult/${id}_blast    cd ~/Methylome_Soybean/sRNA-seq/blastresult/${id}_blast
    blastn -task blastn-short -query ~/Methylome_Soybean/sRNA-seq/fastq/clean_data/${id}_collapsed.fasta -out ${id}_snrna.blast -db ~/Methylome_Soybean/sRNA-seq/blastdb/gm.snrna -outfmt 6 -evalue 0.01 -num_threads 8    blastn -task blastn-short -query ~/Methylome_Soybean/sRNA-seq/fastq/clean_data/${id}_collapsed.fasta -out ${id}_mirna.blast -db ~/Methylome_Soybean/sRNA-seq/blastdb/gm.mirna -outfmt 6 -evalue 0.01 -num_threads 8    blastn -task blastn-short -query ~/Methylome_Soybean/sRNA-seq/fastq/clean_data/${id}_collapsed.fasta -out ${id}_rrna.blast -db ~/Methylome_Soybean/sRNA-seq/blastdb/gm.rrna -outfmt 6 -evalue 0.01 -num_threads 8    blastn -task blastn-short -query ~/Methylome_Soybean/sRNA-seq/fastq/clean_data/${id}_collapsed.fasta -out ${id}_trna.blast -db ~/Methylome_Soybean/sRNA-seq/blastdb/gm.trna -outfmt 6 -evalue 0.01 -num_threads 8    echo "blast on ${id} against gm rRNA/tRNA/snRNA/miRNA completed."  #根据剩余序列ID提取fasta文件    cat *.blast | awk '{print $1}' | sort | uniq > annotated.txt    sed -n '/^>/p' ~/Methylome_Soybean/sRNA-seq/fastq/clean_data/${id}_collapsed.fasta | sed 's/^>//g' | sort > all_seq.txt    sort all_seq.txt annotated.txt annotated.txt | uniq -u > unannotated.txt    perl ~/Methylome_Soybean/sRNA-seq/scripts/getseq.perl unannotated.txt ~/Methylome_Soybean/sRNA-seq/fastq/clean_data/${id}._collapsed.fasta > ${id}.filtered.fasta  #找回被简并的数据    grep -v '>' ${id}.filtered.fasta > ${id}.filtered.list    perl /pub4/zhangchao/Methylome_Soybean/sRNA-seq/scripts/getseq.pl ${id}.filtered.list ~/Methylome_Soybean/sRNA-seq/fastq/clean_data/${id}.fasta > ${id}.filtered.all.fasta  #计算剩余小RNA的长度分布    seqkit fx2tab -l -n ${id}.filtered.fasta |awk '{print $2}'|sort |uniq -c > ${id}.filtered.dis    seqkit fx2tab -l -n ${id}.filtered.all.fasta |awk '{print $2}'|sort |uniq -c > ${id}.filtered.all.disdone
上述getseq.perl脚本
#perl getseq.pl Osa.list Osa.port > Osa.fa#!usr/bin/perl -wopen ID, "$ARGV[0]" || die $!;while (<ID>){ chomp; $hash{$_}=1;}open SEQ, "$ARGV[1]" || die $!;while(defined($line = <SEQ>)){ if($line =~ />/){ $key = (split /\s/,$line)[0]; $key =~ s/>//g;}print "$line" if exists $hash{$key} == 1;}3.4 筛选出 24nt siRNA
Section titled “3.4 筛选出 24nt siRNA”#filter 24nt sRNA from fasta#python orign.fasta filtered.fasta
import sys
fasta = open(sys.argv[1],"r")filtered = open(sys.argv[2],'w')i = 0for line in fasta: if i%2 == 0: seqID = line.strip("\n") elif i%2 == 1: sequence = line.strip("\n") if len(sequence) == 24: qual=line.strip("\n") output = seqID + "\n" + sequence + "\n" filtered.write(output) i += 1